游標分頁詳解:翻閲支付接口列表時如何不漏掉任何一條記錄
游標分頁(cursor-based pagination)詳解:limit、starting_after、ending_before 與 has_more,offset 分頁為什麼會漏數據,以及如何翻完全部頁面。
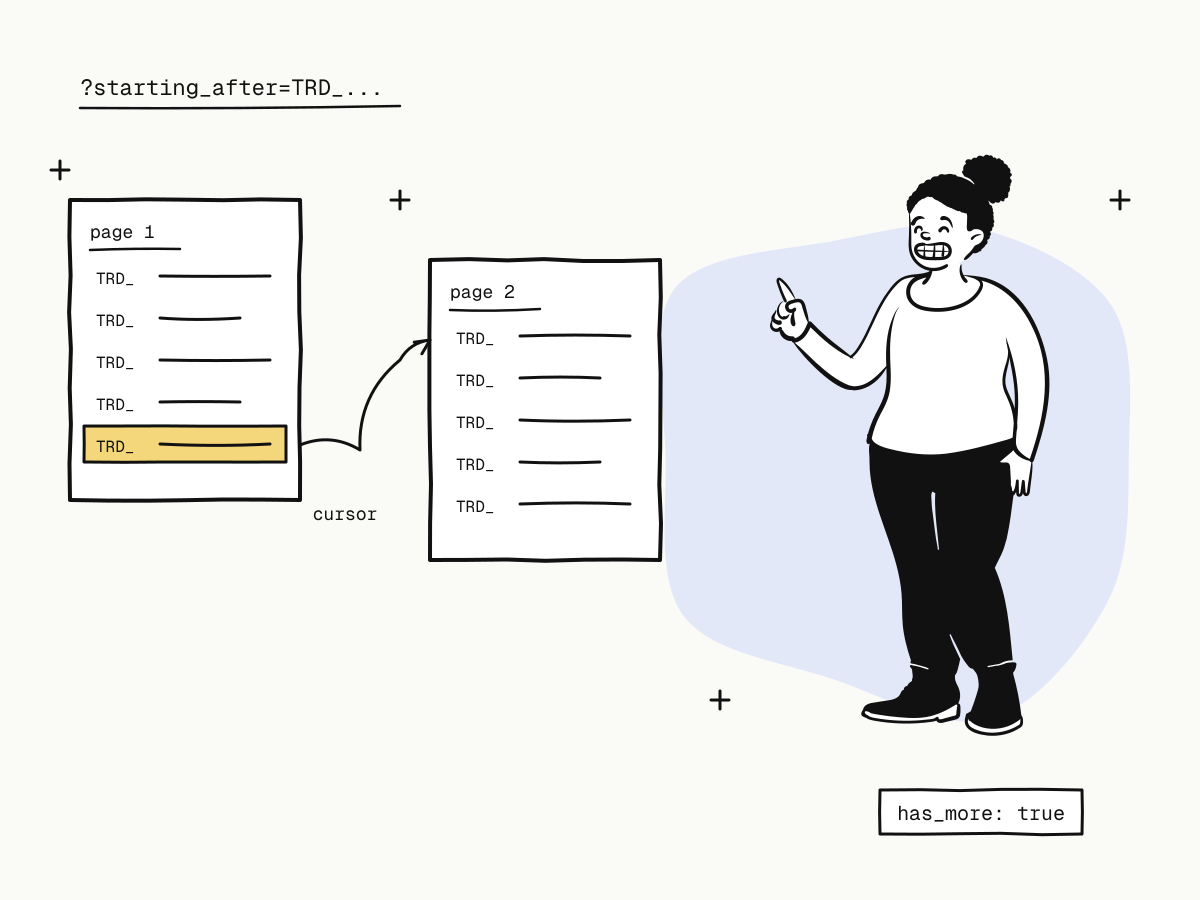
游標分頁(cursor-based pagination)翻閲列表時,靠的是指向某一條記錄,而不是數行數:"給我這一條之後的 100 條"。每一頁最後一個對象的 id,就是請求下一頁時傳回去的游標,接口會告訴你還有沒有下一頁。和 offset 分頁不同,在你翻頁期間有新記錄產生時,游標分頁不會跳過、也不會重複任何一條——當列表裏是支付記錄時,這一點非常重要。
這篇文章説明 KukoPay 接口中游標分頁如何工作、offset 分頁為什麼會丟記錄、如何正確地翻完所有頁面,以及大批量讀取時如何使用時間篩選和 CSV 導出。
游標分頁與 offset 分頁的區別
| offset 分頁 | 游標分頁 | |
|---|---|---|
| 請求 | ?page=3 或 ?offset=200&limit=100 | ?starting_after=TRD_…&limit=100 |
| 錨定在 | 列表中的某個位置 | 某一條具體記錄 |
| 翻頁期間有新數據 | 整體挪位——記錄被跳過或重複 | 不影響已經翻過的頁 |
| 直接跳到第 50 頁 | 可以 | 不行——只能從已知記錄往下翻 |
| 知道總數 | 通常可以 | 不知道——由 has_more 決定是否繼續 |
offset 分頁為什麼會漏數據
offset 的意思是"從第 100 行開始",而行在你讀的時候會移動。
- 有記錄加入列表。 列表按時間倒序。你讀完第 1–100 條訂單,這時產生了一張新訂單,所有記錄都往後挪了一位:下一次請求
offset=100,第一條就是你已經讀過的第 100 條,它會被處理兩次。 - 有記錄離開列表。 你在買家付款的同時翻
status=pending的列表。每一張變成paid的訂單都會從列表裏消失,它後面的記錄往前挪一位,挪進你已經翻過位置的那一條就永遠讀不到了,而且沒有任何提示。
對一個在店鋪收款期間運行的對賬任務來説,兩種情況都意味着合計錯了。這就是為什麼 KukoPay 的所有列表都使用游標分頁,沒有一個接受 page 或 offset。
KukoPay 接口中的游標分頁如何工作
所有列表共用同一組參數:
| 參數 | 含義 |
|---|---|
limit | 每頁條數,1–100,默認 20 |
starting_after | 上一頁最後一個對象的 id:返回下一頁 |
ending_before | 當前頁第一個對象的 id:返回前一頁。不能與 starting_after 同時使用 |
created[gte] / created[lte] | 只返回在這個時間窗口內創建的對象(ISO 8601 或 Unix 秒) |
每個列表都按創建時間倒序排列,只返回當前密鑰在其所屬環境下能看到的數據。響應把一頁數據包在一個列表對象裏:
{
  "object": "list",
  "resource": "order",
  "has_more": true,
  "url": "/v1/orders",
  "data": [
    { "object": "order", "trade_no": "TRD_A1B2...", "status": "paid" },
    { "object": "order", "trade_no": "TRD_C3D4...", "status": "pending" }
  ]
}
游標就是列表對象自己的 id 字段:訂單是 trade_no,退款是 refund_no,拒付是 dispute_no,資金流水和事件是 id,收款鏈接是 link_id,API 日誌是 request_id。
如何翻完全部頁面
請求第一頁
帶上 limit=100 和篩選條件,不帶游標。
處理這一頁
處理 data 裏的每一個對象。
看 has_more 決定停止還是繼續
has_more 為 false 就結束了;否則取最後一個對象的 id,作為 starting_after 傳入。
async function* allOrders(params = {}) {
  let startingAfter
  while (true) {
    const query = new URLSearchParams({ limit: "100", ...params })
    if (startingAfter) query.set("starting_after", startingAfter)

    const res = await fetch(`https://api.kukopay.com/v1/orders?${query}`, {
      headers: { "X-Api-Key": process.env.KUKOPAY_API_KEY },
    })
    const { data: page } = await res.json()

    for (const order of page.data) yield order
    if (!page.has_more) return
    startingAfter = page.data[page.data.length - 1].trade_no
  }
}

for await (const order of allOrders({
  status: "paid",
  "created[gte]": "2026-11-10T00:00:00Z",
  "created[lte]": "2026-11-10T23:59:59Z",
})) {
  console.log(order.trade_no, order.net_amount)
}
游標分頁要避免的錯誤
- 一頁不滿就停止。 請用
has_more。"返回條數少於limit"大多數時候能用,但在邊界上會多請求一次——而且問錯了問題。 - 自己拼游標。 原樣傳回接口返回的 id,不要根據時間戳推算。
- 每天把全部歷史翻一遍。 用
created[gte]和created[lte]縮小範圍,每日任務只讀一天。 - 出錯後從頭重跑。 保存最後處理過的游標,從那裏繼續——已經讀過的頁不會變。
- 忽略調用頻率。 大批量讀取就是大量請求,
429響應會帶Retry-After。見 API 調用頻率限制。
什麼時候改用 CSV 導出
一次性或月底的大批量讀取,可以在訂單、退款、拒付和資金流水列表上傳 format=csv,返回一個文件而不是分頁:每次最多 10,000 行,單獨計算頻率(每分鐘 10 次),導出時忽略 limit / starting_after,篩選條件照常生效。長時間段請拆成多個較小的 created 窗口。基於它的每日流程見 支付對賬。
總結
- 游標分頁把每一頁錨定在一條記錄上,新數據不會讓你跳過或重複記錄——offset 分頁會;
- 在 KukoPay 接口中,每個列表都接受
limit、starting_after和ending_before,按時間倒序,並返回has_more; - 循環直到
has_more為false,每次把最後一個對象的 id 作為starting_after傳入; - 用
created[gte]/created[lte]縮小讀取範圍,出錯後從最後一個游標繼續,大批量一次性讀取用 CSV 導出。
在沙箱裏把它跑通
註冊商戶後即可申請測試密鑰,不需要等待資質審核。